策划 靖程
作者 高雅
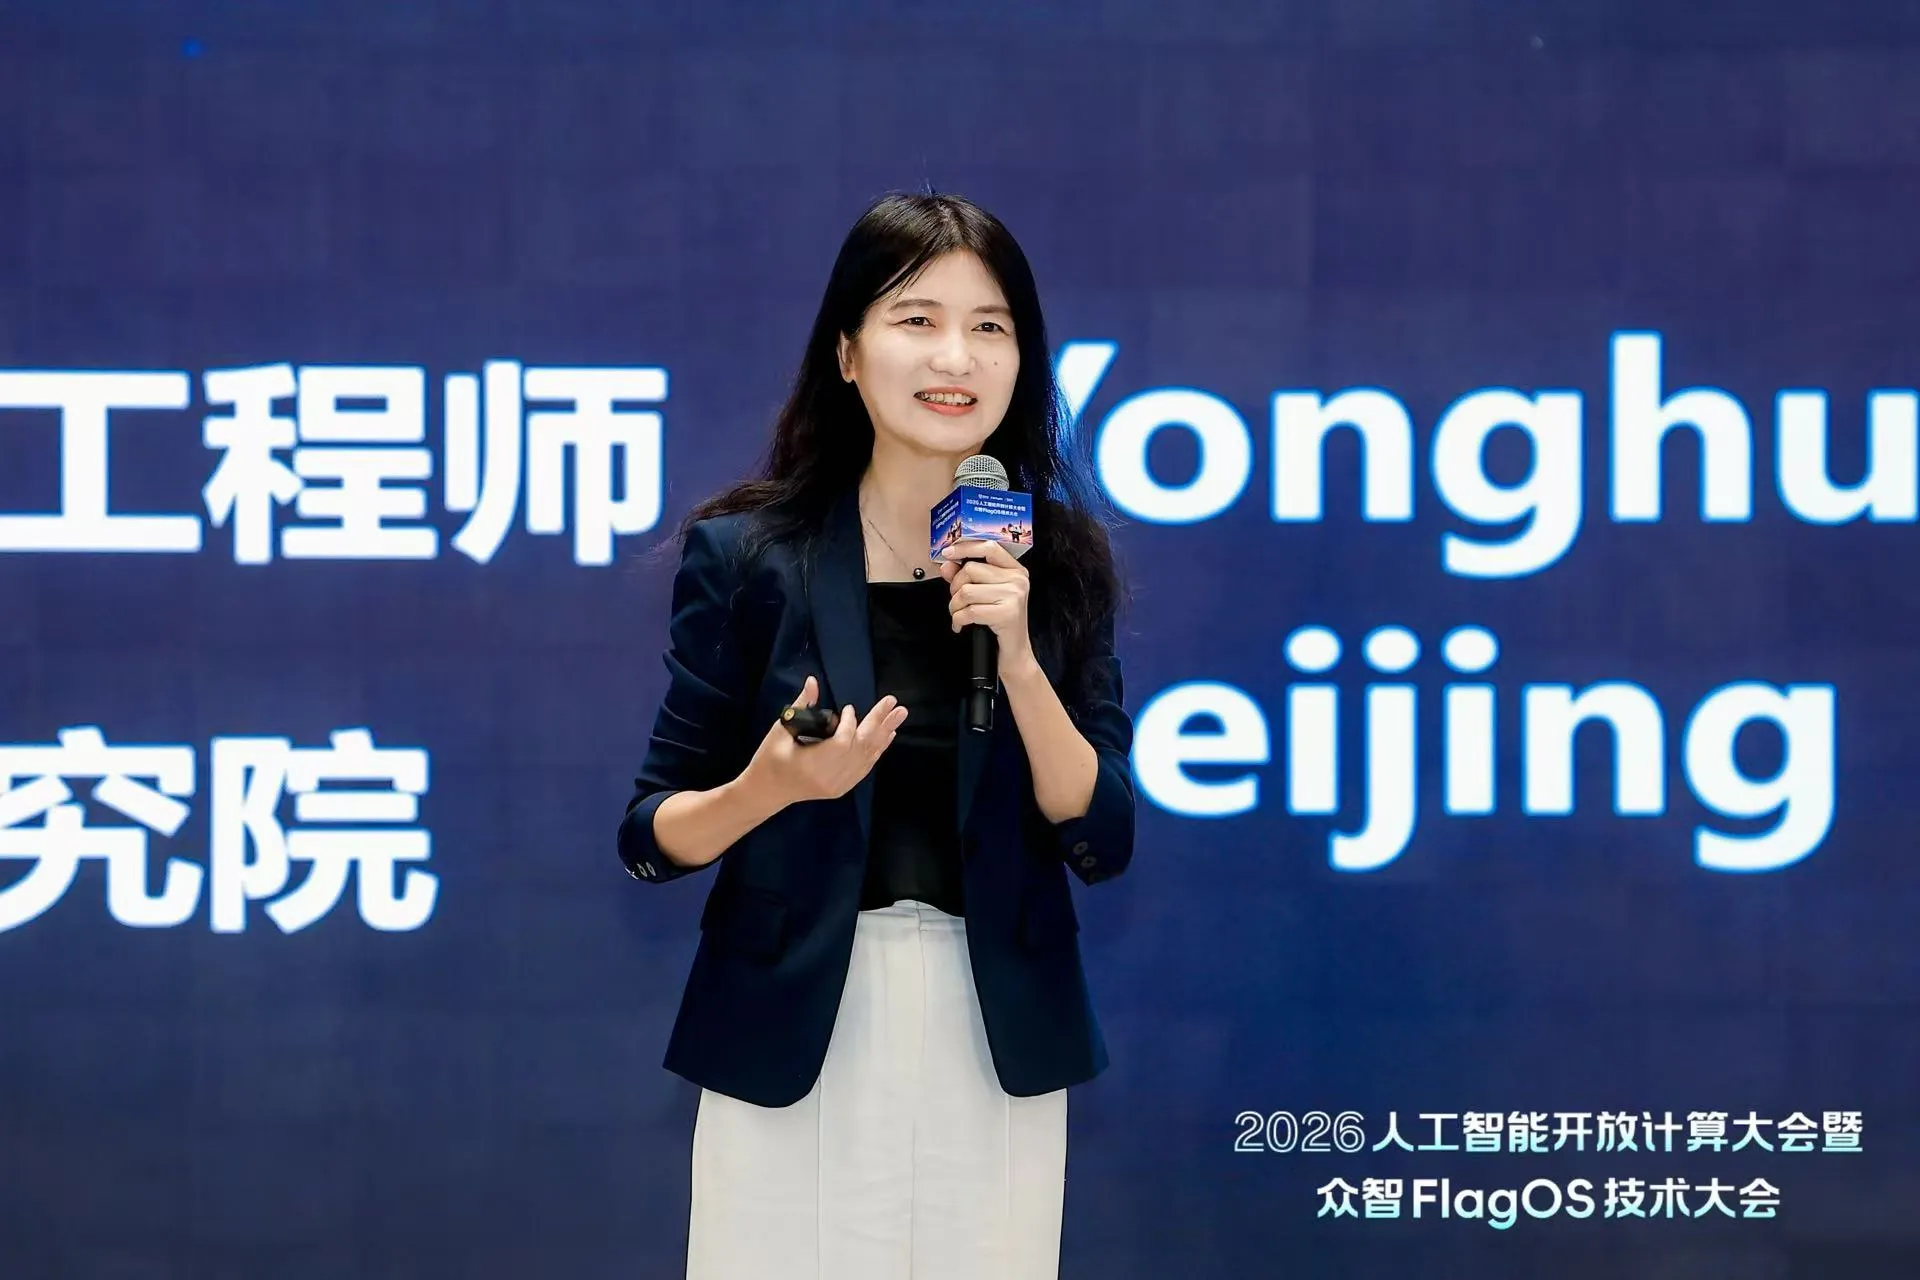
10月17日,2026人工智能开放计算大会于北京举办,众智FlagOS社区正式发布FlagOS 2.2版本,持续沿着AI开放计算技术路线迭代升级,进一步扩大对多元AI芯片与前沿大模型的支持范围。目前FlagOS技术栈已覆盖21家AI芯片厂商,依托统一开放的软件栈,实现不同芯片共享模型适配、算子优化以及系统性能优化成果,加速AI大模型在多元算力硬件上高效落地。在活动现场,智源研究院副院长、总工程师、FlagOS发起人林咏华与财经网科技等媒体对话,围绕新版本价值、产业痛点、落地阻碍以及全球化布局等话题,分享了她对AI开放计算的深度思考。
在林咏华看来,当前大模型行业的竞争逻辑正在发生深刻转变,已经从单纯比拼模型参数、效果能力本身,进一步延伸到算子、编译、通信和运行时等底层系统软件层面。“一方面,超大规模大模型、长上下文能力、多模态生成等技术方向不断演进,持续抬高数据中心的计算、存储与带宽需求;与此同时轻量化端侧模型快速崛起,AI能力加速渗透至AI PC、各类边缘设备以及ARM架构硬件平台,对算力的多样性提出更高要求。另一方面,市场上GPU、NPU、CPU等各类AI芯片百花齐放,国产芯片快速崛起,海外芯片产品迭代加速,硬件供给走向多元化。”林咏华说道。
她直言,在此背景下,行业面临的核心挑战已经不再是“是否拥有足够多芯片”,而是如何解决跨平台兼容难题。如何将一次模型适配、一次算子优化、一轮系统调优沉淀为可复用的能力,让不同品牌、不同架构的算力都能够共享优化成果,降低重复开发成本,正是AI开放计算想要解决的产业命题。而FlagOS的出现,正是希望通过开源开放的软件技术栈,打通模型与异构芯片之间的壁垒。
谈及FlagOS 2.2上线之后,对于云厂商、模型厂商、AI应用开发方带来的实际价值,林咏华坦言,目前行业内还尚未形成一套统一、标准化的可量化成本测算模型,但从大量真实落地的合作实践中可以看到,这套软件栈能够从研发、算子生态、算力使用三个核心层面为全行业降本增效。
“首先是全行业跨芯片研发成本的节约。”林咏华介绍,在过去的产业模式下,头部大模型团队想要完成一个模型在多款芯片上的适配工作,往往需要针对每一家芯片厂商组建专门团队,甚至安排人员驻场对接开发,人力投入巨大,周期长。借助FlagOS,仅依靠小规模的社区团队投入,就可以完成单一大模型在12款不同芯片上的全量适配工作,并且保障端到端模型推理效果不打折扣。
在她的观察中,这种协作模式改变了过去行业“各自为战”、缺少协同、重复投入的局面。对于模型厂商而言,无需投入大量人力进行多芯片适配;对于芯片厂商来说,不再需要针对每一个大模型团队单独对接沟通,省去大量重复对接工作,有效避免全行业重复造轮子。“现在不少芯片厂商已经无需亲自跟进大模型适配的完整流程,只需要等待FlagOS社区完成Day0适配工作、模型厂商正式发布新版本之后,就可以同步对外完成新模型支持的宣发,芯片企业内部研发资源可以更多倾斜到下一代高性能芯片的硬件架构设计、芯片性能打磨等核心工作上。”林咏华说。
此外,算子生态与AI框架对接成本也实现显著下降。“除英伟达借助CUDA生态力量的多年积累可以做到全覆盖,其它芯片厂商很难独立维护规模达到1400个量级、多领域覆盖的开源算子库。”她解释,传统模式下,芯片厂商需要组建规模庞大的算子开发团队,为自家芯片独立开发、迭代、维护专属算子库。与此同时,还要持续投入专门的工程团队,跟进PyTorch、vLLM等主流AI框架的版本快速迭代,完成框架在自家硬件上的适配调试,人力成本居高不下。
林咏华透露,依托FlagOS打造的统一跨芯片插件系统,芯片厂商只需要投入1‑2名工程师,花费2‑3周时间就可以完成主流框架的插件接入工作。接入完成之后,后续上游AI框架的版本迭代、算子库的升级维护、性能调优工作,都由FlagOS社区统一承接完成,芯片厂商不需要持续投入人力跟进迭代,极大降低算子与框架适配的长期人力投入。
“第三,直接降低企业与终端用户的算力实际使用成本。”林咏华进一步拆解,经过FlagOS系统层面的深度优化,在DeepSeek、GLM、MiniMax、MiniCPM等国内主流大模型上,已经实现百分之几十不等的跨芯片性能提升,性能优化直接转化为推理、训练环节的算力开销缩减,降低企业运行AI业务的成本。更具现实意义的是硬件存量盘活价值,从企业IT采购的财务规律来看,AI硬件设备折旧周期长达5年,但是大模型技术迭代速度很快,版本按月更新。如果新研发出来的大模型无法跑在企业已经采购完成的存量硬件之上,就会造成大量算力资源空转,企业不得不反复采购新硬件,造成资源浪费。
在林咏华看来,基于FlagOS的人工智能开放计算,是希望让最新的AI模型和算法可以跑在各种厂商、各种架构、和各种代际的硬件上。因此,FlagOS目前正在推动让最新的AI模型流畅运行在不同代际的硬件设备之上,如GLM5.3-Flash就可以在华为昇腾910B上基于FlagOS有了成倍的加速,为910B这样存量算力带来持续可增长的效益,把企业已经采购硬件的价值发挥到极致,从整个产业层面提升算力资源整体利用效率,推动AI产业走向更加可持续的投入模式。
FlagOS的技术定位向上支撑各式各样的大模型,向下适配种类丰富的异构AI芯片,最终目标就是降低整个行业使用多类型硬件的技术门槛,为中国乃至全球构建自主开放的AI计算生态。目前社区已经和国内头部大模型团队、云厂商、和有着自有算力的企业客户开展紧密合作。
“当前推广落地的核心卡点并不是技术层面,而是市场认知不足。”林咏华一针见血地指出,国内很多AI从业者依旧深陷CUDA生态的路径依赖,并不了解现在已经出现成熟可行的技术方案,能够妥善解决多芯片兼容难题,让多元化的算力硬件高效支撑主流大模型运行。现阶段真正了解FlagOS技术价值的群体还局限在较小的行业圈层之中。对此她表示,社区正在持续发展生态合作伙伴,依托合作伙伴的渠道能力,把技术方案辐射给更多行业主体,逐步完成市场认知教育工作。
谈及全球生态,林咏华向财经网科技等表示,打造全球生态是FlagOS当前重点推进的方向。放眼全球AI算力格局,除中国、美国市场之外,大量发展中地区以及发达经济体都面临算力供给不足的现实困境。同时受全球供应链环境影响,各个国家和地区的算力建设方,都希望主动布局多算力供给体系,以降低业务风险。
据林咏华观察,不少海外客户,在采购英伟达芯片之外,同步引入AMD、高通等厂商硬件产品,同时也在积极评估中国AI芯片的成熟度,希望把中国算力纳入自身的算力可选供给清单。她介绍,FlagOS社区一方面积极参与全球开源社区协作,另一方面正在和联合国相关机构开展对接合作,共同推进全球AI开放计算方案落地。这套开源方案可以充当中立的技术底座,让用户不必被绑单一算力产品,基于FlagOS这套开源技术栈,无论是英伟达、AMD等海外芯片,还是昇腾、平头哥等国产芯片,都能够无缝运行全球主流大模型与AI应用,不会因为硬件来源不同而遭遇软件生态适配障碍。
“FlagOS几乎是目前全球为数不多能够实现这一能力的技术方案,它可以让不同国家、不同厂商的芯片,在同一套开源技术栈之下平等为全球AI应用提供算力支撑,对于推动全球AI生态普惠均衡发展有着十分独特的价值。”林咏华最后总结道。