11 月 10 日晚,MiniMax 发布图像生成模型 MiniMax H3-Image,并同步开放模型权重。
该模型由 MiniMax H3 衍生,支持文生图、图像参考和图像编辑。在 H3 预训练赋予的广泛图像能力基础上,H3-Image 进一步强化了整个后训练链路,数据、强化学习、步数压缩、PE、部署优化等多方面提升使得 H3-image 同时具备了速度、画面质量、指令遵循三方面竞争力。
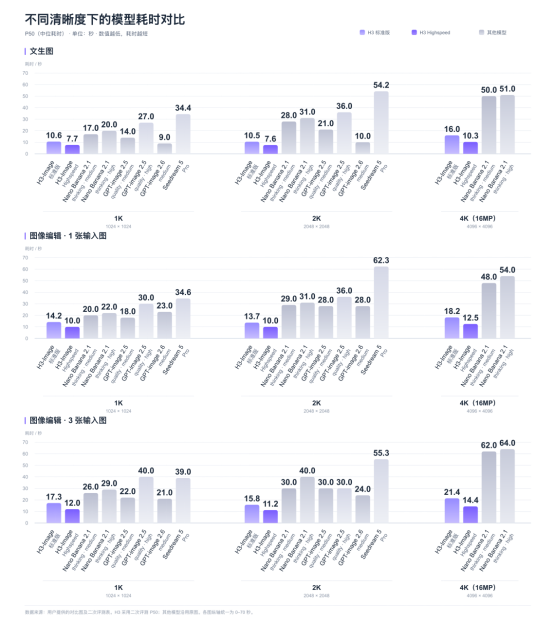
据介绍,MiniMax H3-Image 可以在 10s 内生成一张 4096 × 4096 像素,约 16MP(4K) 的高规格图像,且速度可达市面主流水平的 5 倍。画面质量上,模型提供了丰富的画面细节和极强的真实感,AI 生成图像与真实视觉世界之间的距离进一步缩小。此外,H3-Image 拥有开源模型中顶级的指令遵循能力并最多支持 16 张参考图片。
MiniMax 同时通过开放平台、MiniMax Code 和 MiniMax 海螺提供 H3-Image 图像生成服务。H3-Image 标准模式的生成速度约为市面主流工具的 1.5 至 2 倍,Highspeed 模式可达 3 至 4 倍,服务定价约为同档位主流工具的 50% 至 70%。
发布首周,MiniMax 对 16 MP 及以上规格的生成请求提供官方定价五折优惠。
MiniMax H3 发布三个月后,MiniMax 将开放权重的策略从视频生成延伸到图像生成。在模型架构方面,H3 Image 移除了 H3 原有架构中的音频分支,针对图像生成和编辑进行了优化。Hugging Face公布的技术资料显示,H3 Image采用331亿参数的稠密扩散Transformer(DiT),共有50层,沿用MiniMax H3的Qwen3-VL文本编码器,并结合图像VAE处理参考图片和生成图像。
企业和开发者可以基于模型权重探索新的工具和创作方式,也可以通过 MiniMax 开放平台等官方渠道直接使用高质量生成服务。通过 H3-Image 的官方 API,个人开发者可以在 MiniMax Code、WorkBuddy、Codex 等智能体中接入日常工作流,让图像生成成为各类 Agent 框架可调用的基础能力。
H3-Image 的发布将开源图像模型的能力上限提升到新的维度,即能否准确理解复杂的创作要求,以及能否把这些要求转化为有美感、有真实感的画面。一张包含文字和多层信息的图像,既要把内容和关系交代清楚,也要让构图、光影和细节服务于创作者的意向表达。H3-Image 将指令遵循、多图参考与高分辨率生成结合起来,延续了 MiniMax 的多模态融合路线,也为开源模型在复杂视觉创作中缩小与顶尖闭源模型的差距提供了新的可能。
开源首日,MiniMax 携手华为昇腾、平头哥、昆仑芯、摩尔线程、壁仞、海光、沐曦、天数、NVIDIA、AMD、英特尔、Tenstorrent等全球芯片企业与多家主流推理和云服务平台推进Day 0接入工作。MiniMax表示,“希望 H3-Image 能够给更多人的日常生活、工作带来便利,我们也会持续构建更强有力的工具来帮助普惠 AGI 的实现。”
免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。